Conversation privée
Rédigez, résumez, traduisez, comparez et analysez votre travail dans une interface de chat familière.
Exemple · Rédiger une lettre client à partir de ces notes
L’utilisation de selbsai reste familière. Branchez le serveur IA local préconfiguré à l’alimentation et au réseau autorisé, démarrez-le puis ouvrez selbsai.local. Vos ordinateurs restent de simples clients pendant que le serveur exécute l’IA.
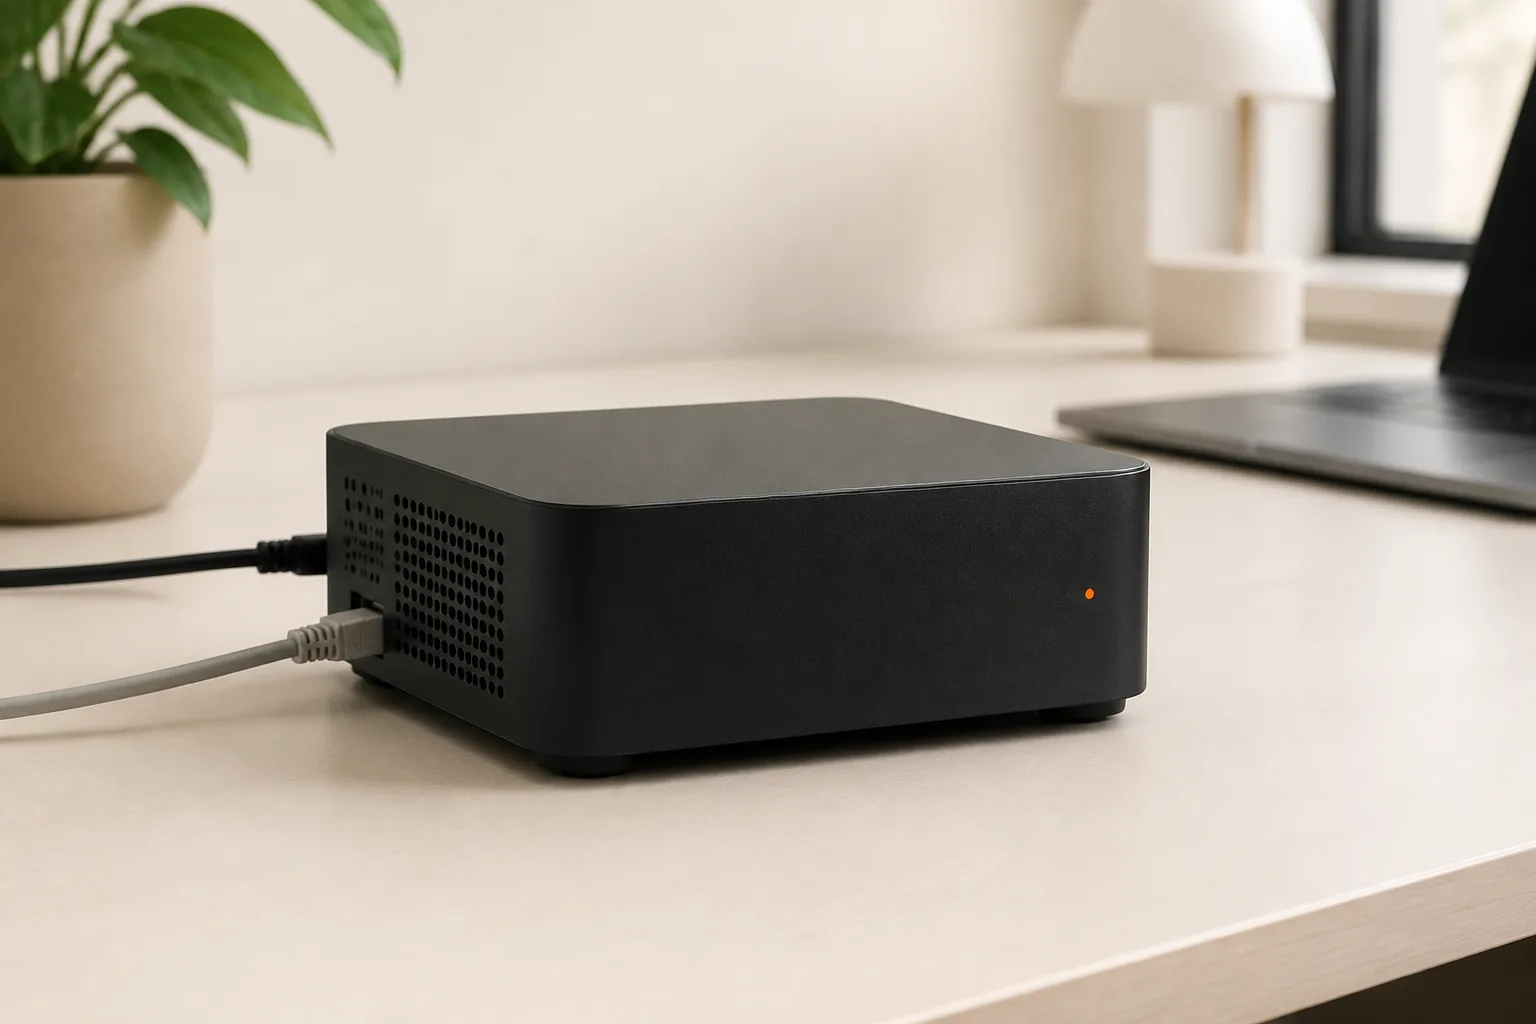
SelbsAI Server est une appliance serveur x86-64 dédiée au format mini-PC compact, livrée avec mémoire, stockage, Linux, runtime, espace privé et récupération préparés.
Ouvrez selbsai.local depuis les appareils autorisés.
Reliez les IDE et agents autorisés au point local.
Quatre actions suffisent : alimentation, Ethernet, démarrage de l’appliance et ouverture de l’espace local.
Branchez l’alimentation fournie et Ethernet au réseau local autorisé.
Appuyez sur le bouton de l’appliance et attendez l’état prêt indiqué sur la carte de démarrage.
Ouvrez l’adresse depuis un ordinateur autorisé du même réseau.
Choisissez un espace, écrivez votre demande ou ajoutez un document. Le modèle local sélectionné traite la tâche.
La carte fournie indique l’adresse locale, le contrôle de santé, l’arrêt et la récupération. Aucun changement des postes clients n’est requis.
Ouvrez un navigateur, choisissez votre tâche et écrivez naturellement. Le workflow normal ne demande ni terminal, ni syntaxe de commande, ni tableau de bord de modèles.
Rédigez, résumez, traduisez, comparez et analysez votre travail dans une interface de chat familière.
Travaillez avec des fichiers PDF, Word, tableurs et textes approuvés sans envoyer la tâche principale à un cloud modèle.
Ouvrez la même interface depuis un ordinateur portable ou une tablette sur le réseau local approuvé pendant que SelbsAI Server exécute l’inférence.
Le serveur peut rester allumé au bureau. Ouvrez selbsai.local depuis un ordinateur autorisé et continuez avec les espaces et conversations stockés localement.
Le navigateur envoie le travail au SelbsAI Server via le réseau local. Sa propre mémoire et son processeur exécutent le modèle et renvoient la réponse localement.
Le paiement, les mises à jour optionnelles, le support et le préchargement optionnel utilisent des services en ligne clairement définis. L’inférence locale principale ne nécessite aucun compte de cloud modèle.
Core et Pro utilisent la même adresse locale et le même workflow navigateur. La mémoire, le stockage et la marge de modèles et de concurrence intégrés changent.
Rédaction privée, Q&R documentaire, transcription, recherche et workflows bureautiques ciblés.
Collections documentaires plus grandes, code, workflows multiples et inférence locale à mémoire élevée.
Private drafting, document Q&A, transcription, research, and focused office workflows.
Larger document collections, coding, multi-workflow setups, and high-memory local inference.
L’appliance gère la configuration et l’inférence. Le travail quotidien reste dans un navigateur familier.