Conversación privada
Redacta, resume, traduce, compara y analiza trabajo en una interfaz de chat familiar.
Ejemplo · Redactar una carta para un cliente a partir de estas notas
Usar selbsai resulta familiar. Conecta el servidor de IA local preconfigurado a la alimentación y a la red autorizada, enciéndelo y abre selbsai.local. Tus ordenadores siguen siendo clientes mientras el servidor ejecuta la IA.
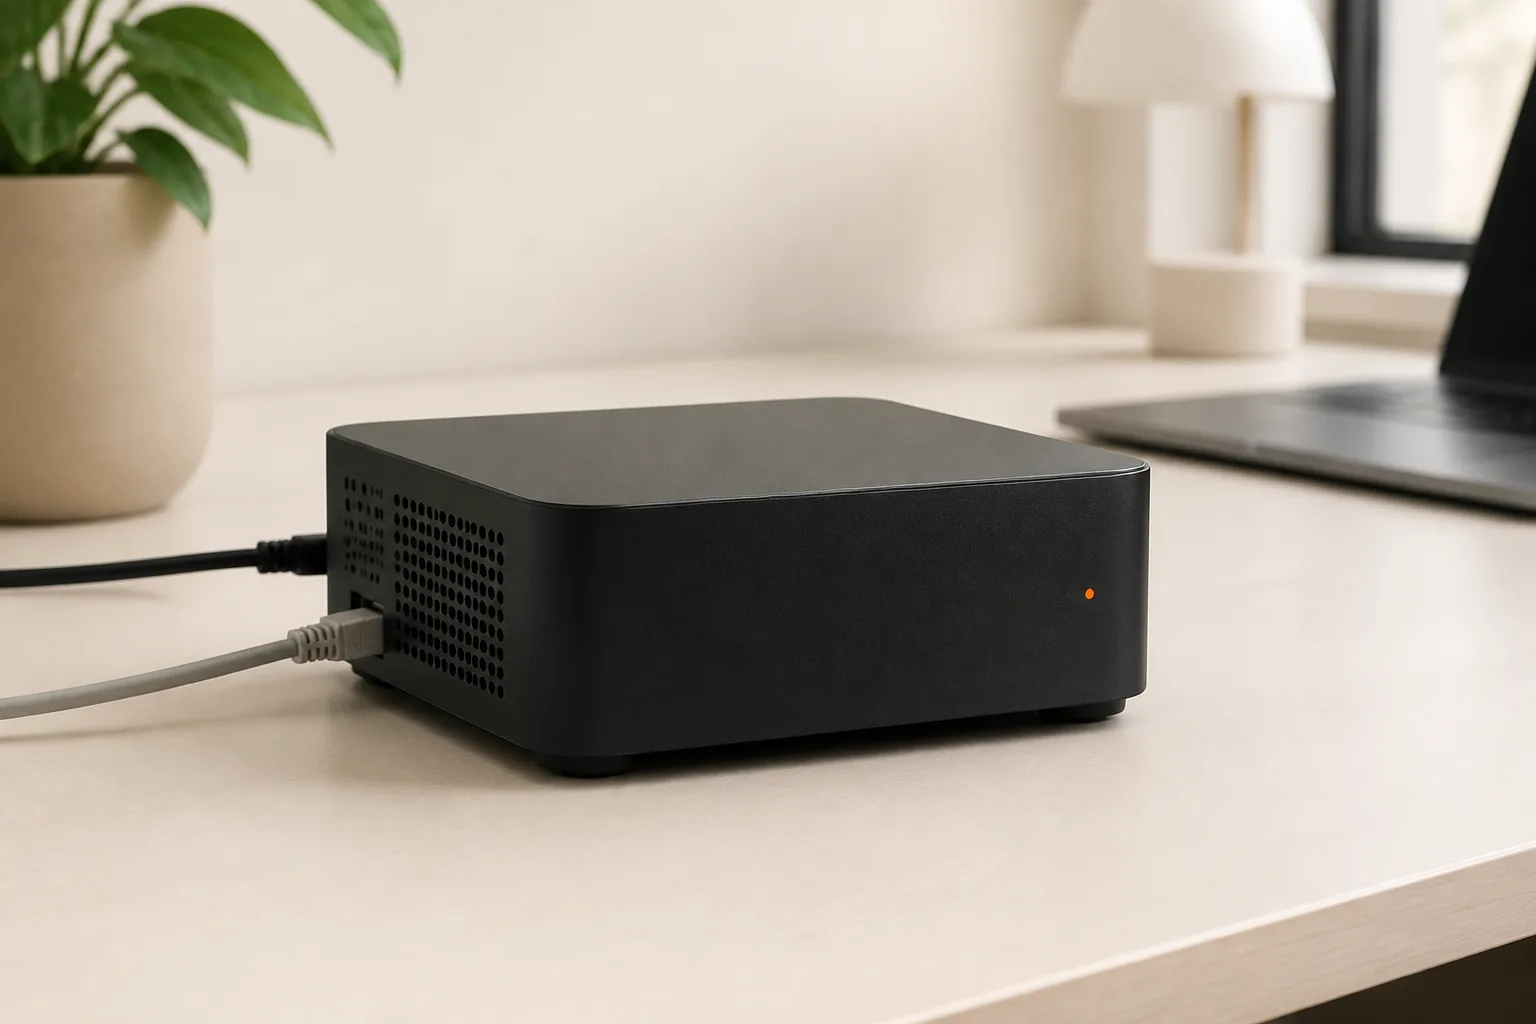
SelbsAI Server es un servidor appliance x86-64 dedicado en formato mini PC compacto, con memoria, almacenamiento, Linux, runtime, espacio privado y recuperación preparados.
Abre selbsai.local desde equipos autorizados.
Conecta IDE y agentes autorizados al endpoint local.
Son cuatro acciones: alimentación, Ethernet, encender el equipo y abrir el espacio local.
Conecta la fuente incluida y Ethernet a la red local autorizada.
Pulsa el botón del equipo y espera al estado listo indicado en la tarjeta de inicio.
Abre la dirección desde un ordenador autorizado de la misma red.
Elige un espacio, escribe tu petición o añade un documento. El modelo local seleccionado procesa la tarea.
La tarjeta incluida indica la dirección local, el estado, el apagado y la recuperación. No hacen falta cambios en los equipos cliente.
Abre un navegador, elige la tarea y escribe con naturalidad. El flujo habitual no requiere terminal, sintaxis de comandos ni panel de modelos.
Redacta, resume, traduce, compara y analiza trabajo en una interfaz de chat familiar.
Trabaja con archivos PDF, Word, hojas de cálculo y texto aprobados sin enviar la tarea principal a una nube de modelos.
Abre la misma interfaz desde un portátil o una tableta en la red local aprobada mientras SelbsAI Server realiza la inferencia.
El servidor puede permanecer encendido en la oficina. Abre selbsai.local desde un ordenador autorizado y continúa con los espacios y conversaciones almacenados localmente.
El navegador envía el trabajo a SelbsAI Server por la red local. Su propia memoria y procesador ejecutan el modelo y devuelven la respuesta localmente.
El pago, las actualizaciones opcionales, el soporte y la precarga opcional usan servicios online claramente definidos. La inferencia local principal no necesita una cuenta de nube de modelos.
Core y Pro usan la misma dirección local y el mismo flujo. Cambian la memoria, el almacenamiento y el margen para modelos y concurrencia incluidos.
Redacción privada, preguntas sobre documentos, transcripción, investigación y flujos de oficina concretos.
Colecciones documentales mayores, código, varios flujos e inferencia local con mucha memoria.
Private drafting, document Q&A, transcription, research, and focused office workflows.
Larger document collections, coding, multi-workflow setups, and high-memory local inference.
El equipo gestiona la configuración y la inferencia. El trabajo diario permanece en un navegador familiar.